

 发布内容








OpenAI推出图像生成新神器,迄今为止业界最强!
2025年3月26日凌晨,科技界迎来了一场激烈的激战。
谷歌发布了号称最强推理模型的Gemini Pro 2.5,而OpenAI也不甘示弱,创始人兼CEO萨姆·奥特曼迅速开直播,推出了迄今为止最先进的图像生成器:
GPT - 4o图像生成。
其效果非常惊艳,可以说是图片领域的ChatGPT3.5时刻!
粒子熔炉今天为大家带来深度的AI测评,挖掘出他的潜力,为大家展示他带来了什么可能性。
精准渲染文本内容
GPT - 4o在图像中渲染文字的能力堪称一绝。以往的AI模型在生成清晰、位置恰当的文字方面存在困难。
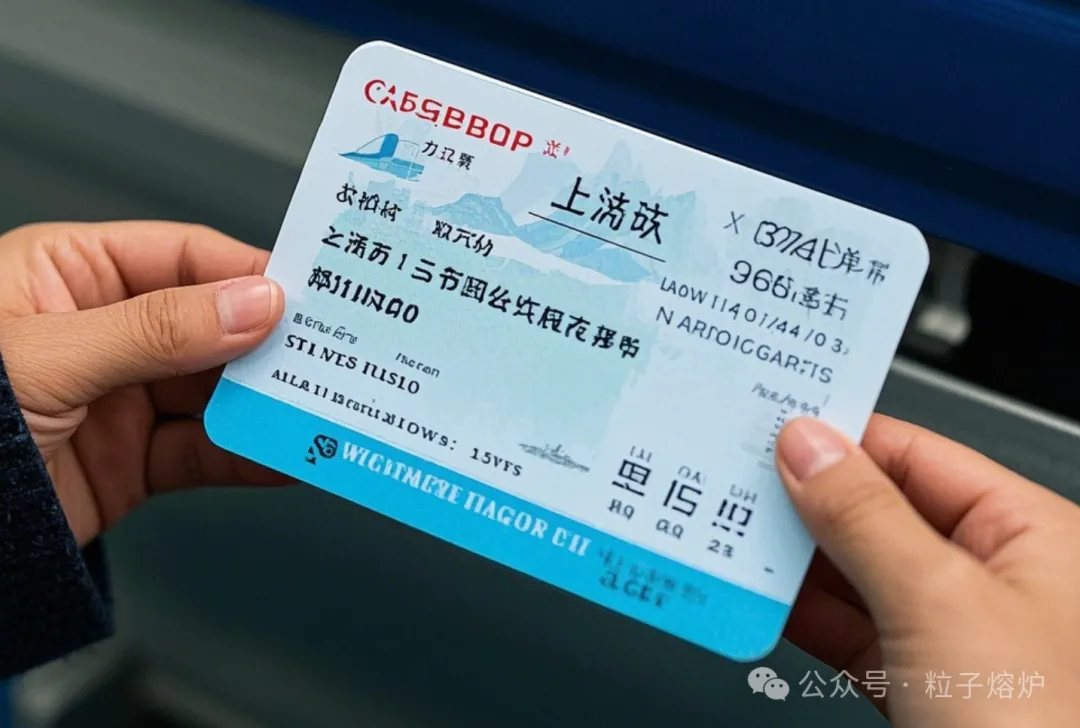
但GPT - 4o可以准确地将文字嵌入图像中。
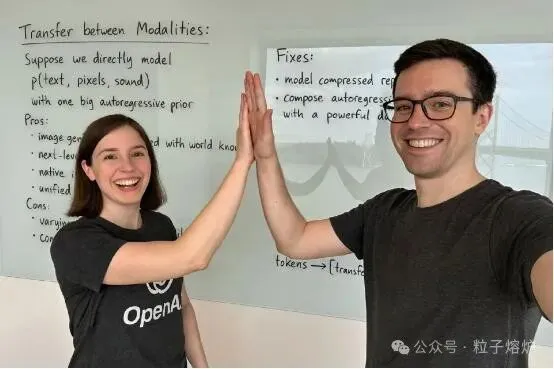
这是官方的一个演示案例:
提示词:
在俯瞰海湾大桥的房间里,用手机拍摄了一张玻璃白板的大幅照片。视野中,一位女性正在写字,她穿着一件印有大型OpenAI标志的T恤。
笔迹看起来很自然,有点凌乱,我们看到了摄影师的倒影。
黑板上的在官方的提示词中,还把黑板上所有的文案都写上去了!(这里粒子熔炉省略了)
这是最后生成的效果:
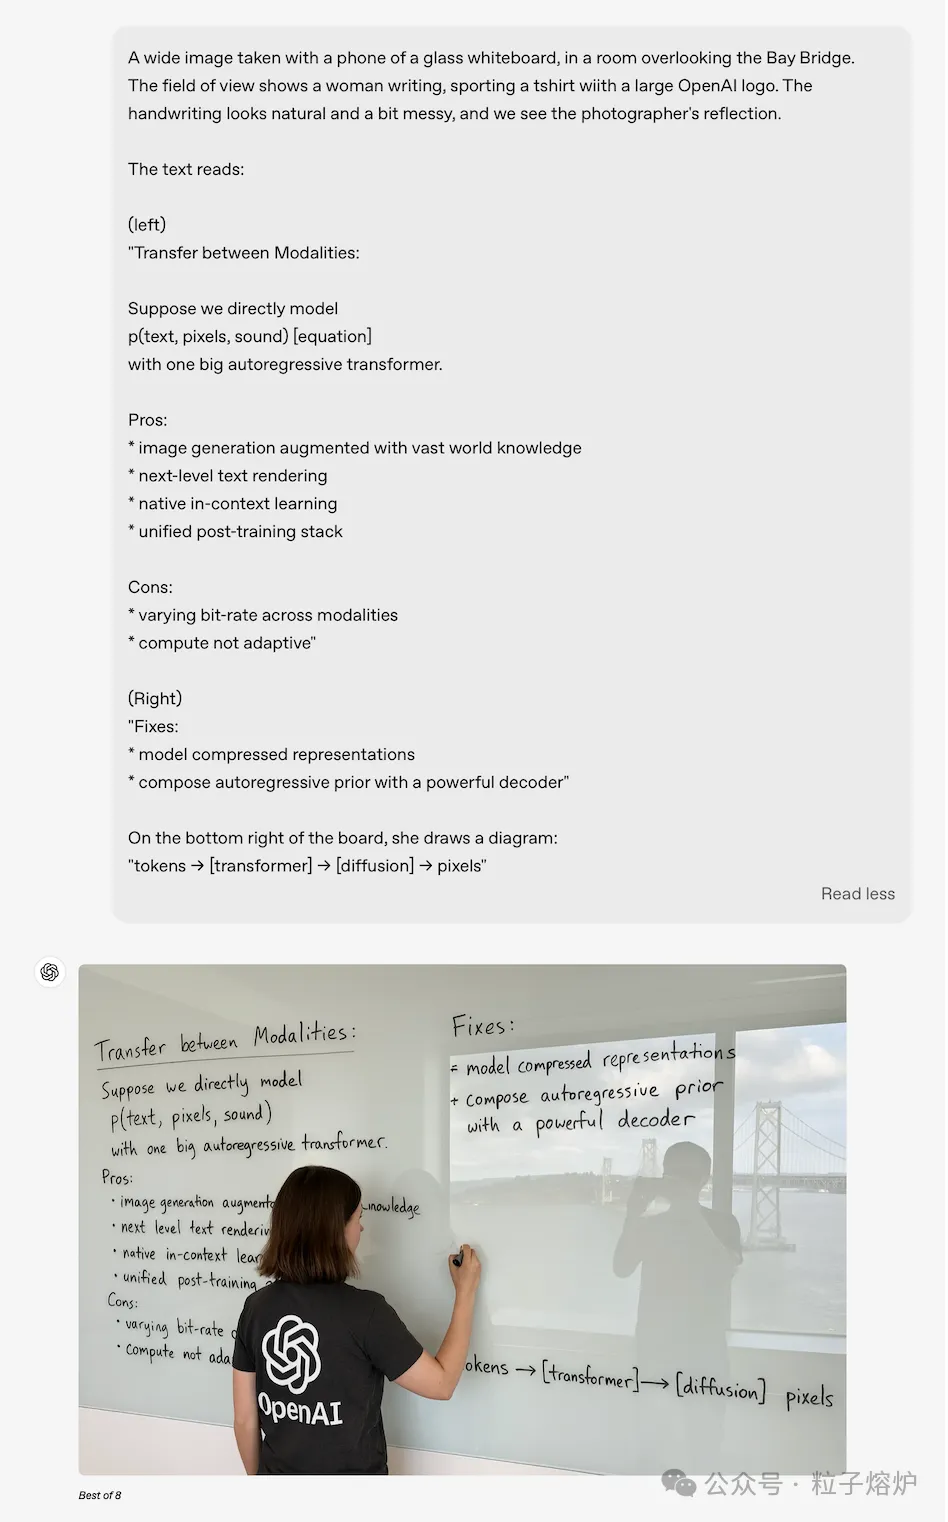
可见,不管是位置,还是字体,文字都非常准确地生成了。画面也非常准确,简直就像相机拍出来的一样。
在接下来的演示中要求第二张图片转了人物朝向,以摄影师的自拍角度,画面中的女性转向与他击掌,生成的图像还是完全看不出出自 AI。
精确执行复杂指令
该模型能够处理复杂指令,甚至在细节丰富的构图中也能表现出色。它可以一次处理多达10 - 20个复杂指令,远超其他竞争对手只能处理几个简单指令的限制。
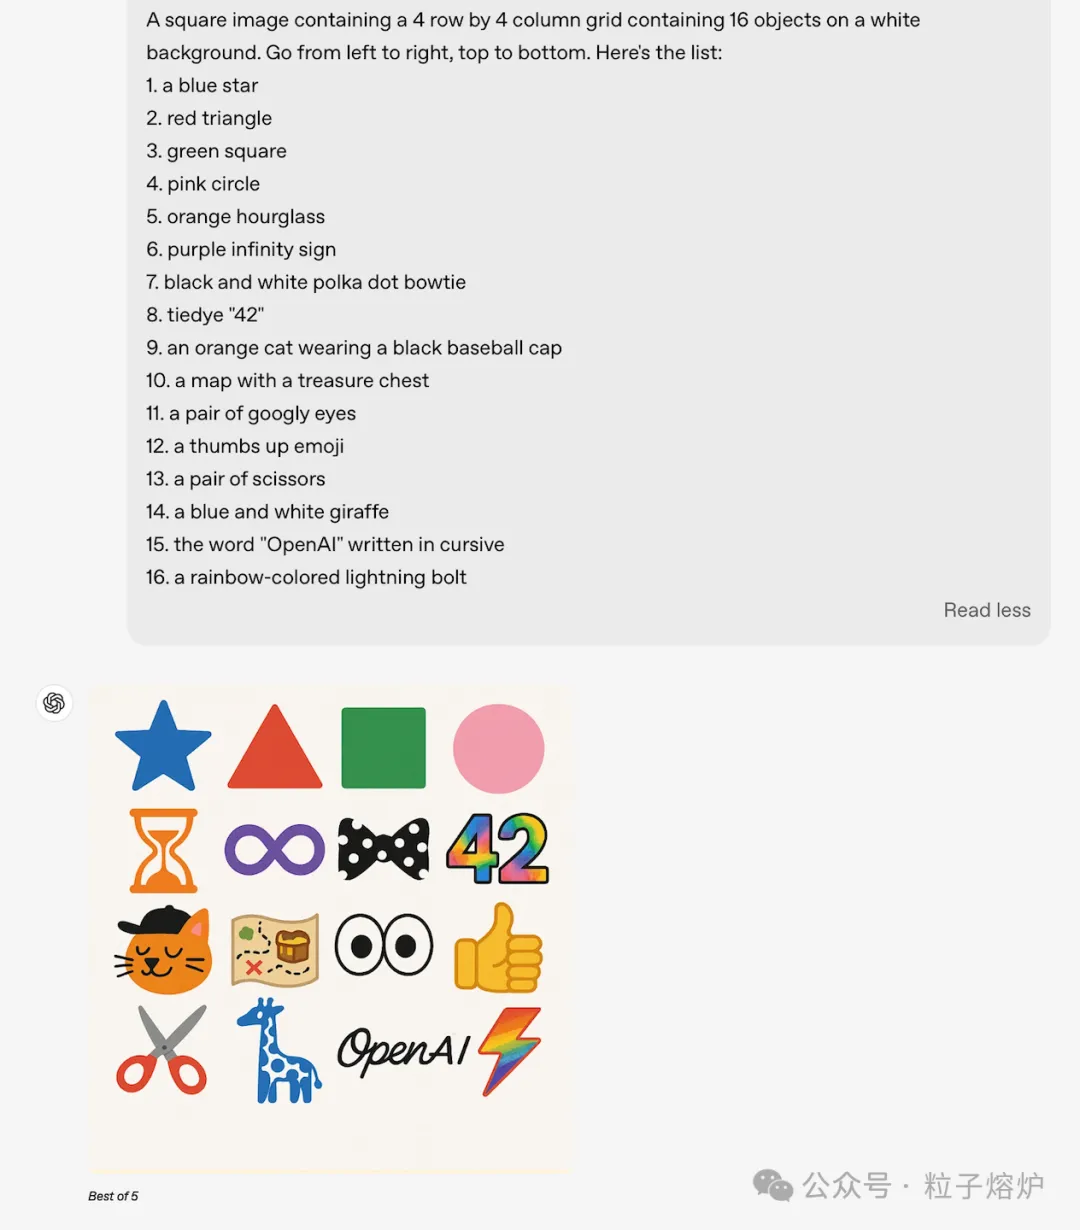
在官方的另一个演示案例中,让AI生成一张图,其中有各种元素:
一个正方形图像,包含一个4行乘4列的网格,在白色背景上包含16个对象。从左到右,从上到下。以下是列表:
1.一颗蓝色的星星,2.红色三角形,3.绿色广场,4.粉红色圆圈,5.橙色沙漏(后边省略)
AI非常完美的理解了意思,并且很完美的生成了图片:
AI还能理解并创建更加复杂的指令,
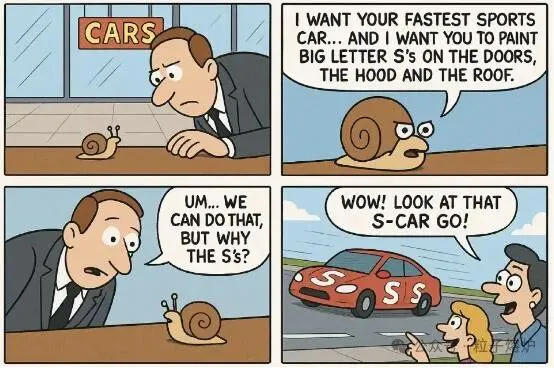
例如要求AI创作一个漫画:讲述了一只小蜗牛购买跑车的故事。
提示词:
「一只小蜗牛身在华丽的汽车展厅柜台上,推销员俯下身来才能看到他。
特定镜头中,蜗牛表情严肃,说‘我想要你们最快的跑车……还得在车门、引擎盖和车顶位置画上大写的「S」。’
销售员挠挠头,‘呃……当然没问题。不过为什么是「S」?’
画面切换到时一辆红色汽车在高速公路上呼啸而过,车身上写满巨大的「S」。
路旁的人们指指点点,笑着说,‘WOW! LOOK AT THAT S‑CAR GO!’」
这是最后生成的图片:
场景的细节把控
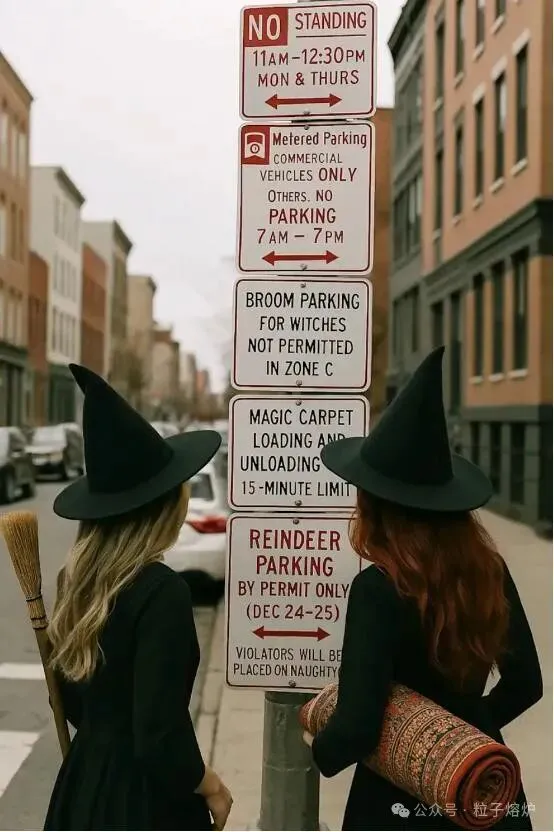
官方另一个令人印象深刻的例子是「纽约威廉斯堡街道上的女巫阅读路牌」场景。
生成的图像不仅包含了提示词中要求的灰色挑染和赤褐色波浪长发的两名女巫,还精确呈现了各种详尽的街道标志。
包括「C区禁止停泊女巫扫帚」和「仅允许魔毯卸货(不超过15分钟)」等架空信息,同时保持了标志的真实风格和复杂的场景构图。
支持多轮生成与风格转换
现在图像生成已成为GPT - 4o的原生功能,用户可以通过自然对话实现图像内容优化。
在官方的一个示例中,首先上传了一只猫,要求添加侦探帽和单片眼镜
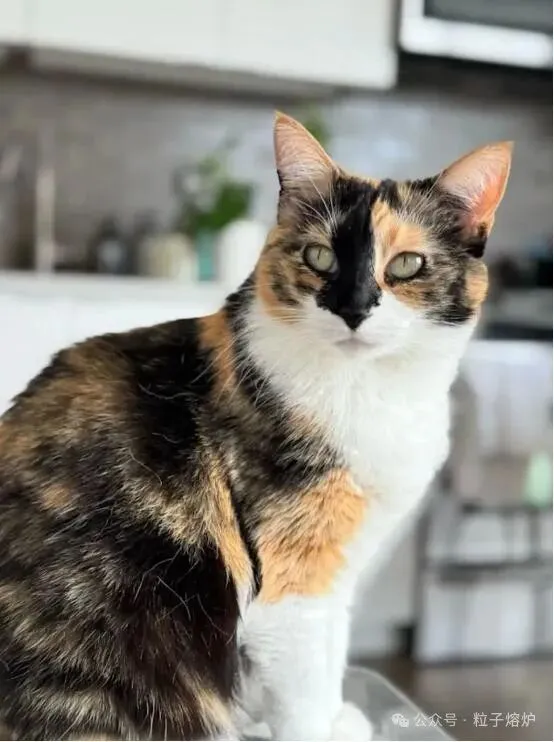
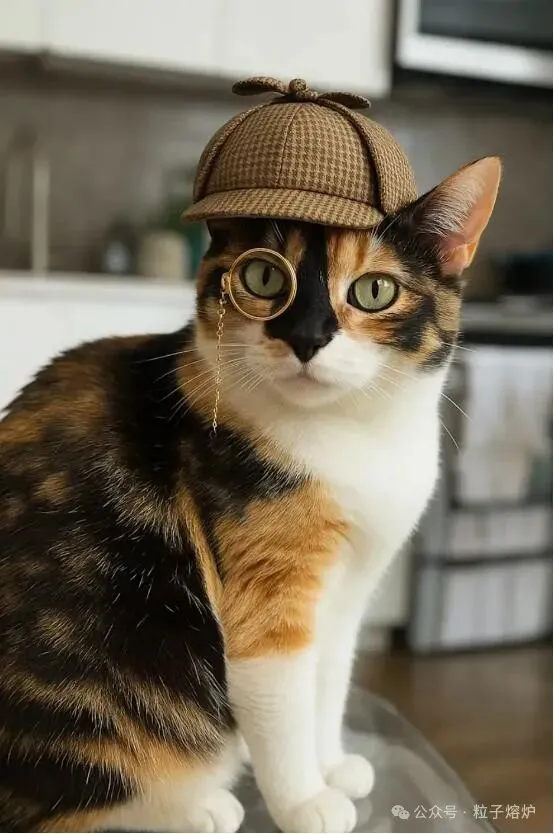
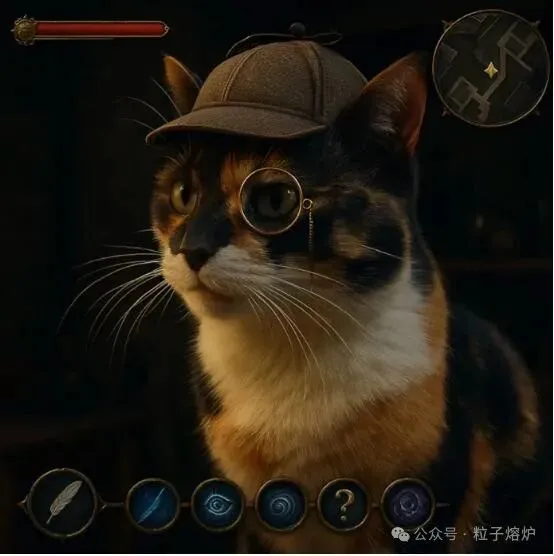
之后要求将图片转化为3A游戏风格,并添加用户界面元素顶部有生命栏和小地图等元素
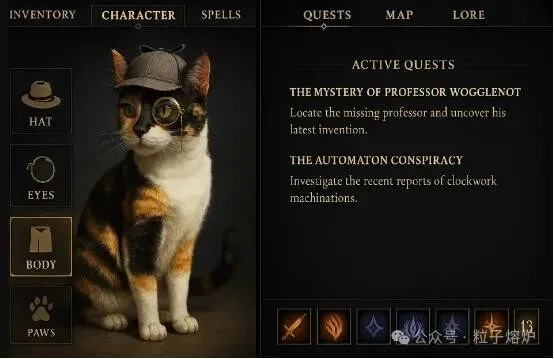
然后在要求创建一个游戏界面,显示小猫的角色资料和装备,右侧有任务
多模态输入输出与上下文理解
GPT - 4o支持多模态输入输出,包括文本、图像、音频。
它能理解复杂指令并结合上下文进行图像生成。
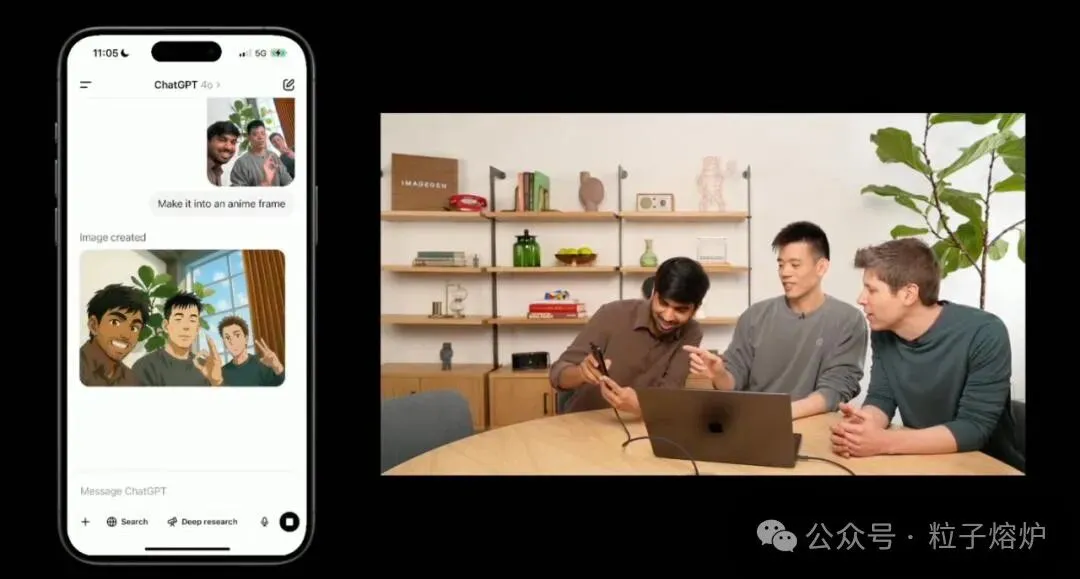
比如在官方直播中演示者拍了张三人的合影,让ChatGPT改成动漫风,模型不仅保留了三人的特征,还能理解并融合动漫这一视觉风格。
更复杂抽象的图片
在官方的演示中,还演示了一个非常复杂的例子,要求生成一张解释牛顿棱镜实验的图片。
在这个图片中,首先要求图片要有非常精准的物理规律,同时还要求AI对图片有精准的理解,并为图片添加合适标注。这是AI最后生成的效果:
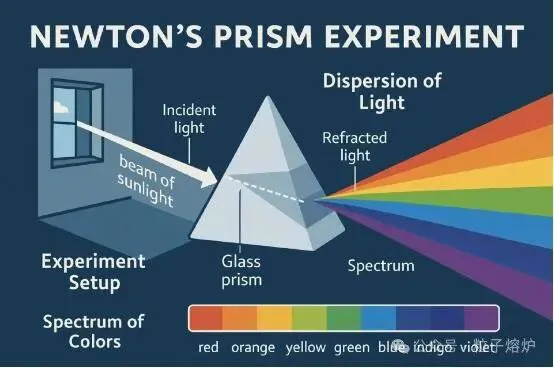
可以看到图片生成得非常完美。光线折射的物理规律完美的演示出来了。
价格优势与广泛的用户覆盖
OpenAI声称与GPT4 Turbo相比,GPT4o的价格降低了50%。
更直观地说,GPT4o成本是GPT3.5的10倍,具体为5美元/百万输入token和15美元/百万输出token。
而且,OpenAI承诺向Plus、Pro、Team和免费用户开放,Enterprise和Edu用户也即将获得访问权限,开发者们几周后也能通过API用上这一功能。
安全保障措施到位
虽然GPT4o功能强大,但OpenAI也十分重视安全性。
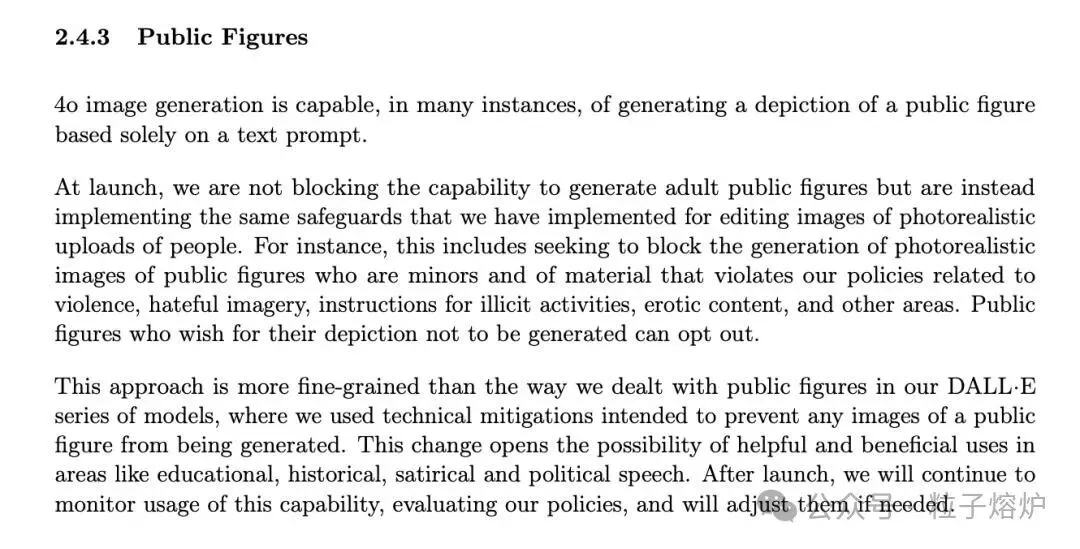
首先,通过C2PA与内部可逆搜索进行溯源,生成的所有图像均带有C2PA元数据,用于注明图像来自GPT4o以保证公开透明。
其次,坚决屏蔽不良内容,阻止可能违反内容政策的生成图像请求,如深度伪造色情图像等。
对于上下文内的真人图像,会加强创建图像的限制,并对裸露及暴力画面采取严格处理措施。
此外,还使用推理增强安全性,训练了一套推理大模型,负责根据人类编写的可解释安全规范识别并解决政策中的歧义。
存在的局限性与改进方向
尽管GPT-4o表现出色,但也并非完美无缺。
目前发现其存在一些局限性,如偶尔裁剪不恰当、在低上下文提示下可能产生幻觉、渲染非拉丁语言文本困难、局部调整不够精细等。
不过,OpenAI表示会在发布后慢慢优化这些问题,例如对用户上传的人脸的编辑一致性错误将在一周内得到修复。
结语
OpenAI此次发布的GPT-4o图像生成模型,无疑是在AI领域投下的一颗重磅炸弹。
它不仅在图像生成能力上实现了重大突破,还通过多模态融合和文本处理的深化,为用户带来了更加丰富和智能的创作体验。
随着技术的不断进步和优化,GPT-4o有望在更多领域发挥其巨大的潜力,推动人工智能技术在图像创作、教育、广告等多个行业的广泛应用。
图像创作领域相信马上就会迎来翻天覆地的变化。
估计很快就会有各种图片AI应用爆发了。 点赞
 反对
 收藏
 分享

AM易道
读懂3D打印卓越与演变之道
 标签
 近期热门




 读懂3D打印卓越与演变之道
 京公网安备11010802046387号
 AM易道
 粒子熔炉