

 发布内容


麻省理工科技评论:GPT-4o重大失误凸显OpenAI中文模型训练乱象
导语:
近日,OpenAI发布的全新AI模型GPT-4o在中文训练数据方面的失误引发了广泛关注。MIT Technology Review对此进行了深入报道,揭示了这一事件背后的技术困境和行业挑战。AM易道第一时间为读者带来这篇文章的中文翻译,并分享我们的独家见解。GPT-4o的「翻车」绝非孤例,它提醒我们在AI时代,数据质量与模型性能密不可分。这场围绕人工智能的狂欢,中文区略显尴尬。
原文信息
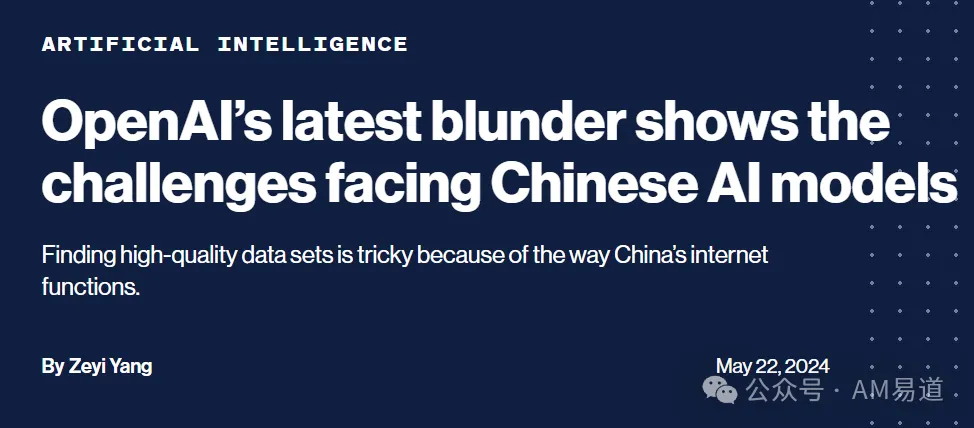
原文题目:OpenAI最新失误凸显中文AI模型训练之殇
原文出版:MIT Technology Review
原作者:Zeyi Yang
翻译:AM易道
正文翻译
上周二,OpenAI发布了一款名为GPT-4o的全新AI「全能模型」,你可以用语音、文本或视频与之交互。
这本该是OpenAI的一个重要时刻,但仅仅几天后,该公司似乎就陷入了困境。从其安全团队大部分成员辞职,到斯嘉丽·约翰逊指控其未经同意复制她的声音用于训练模型,OpenAI如今正在全力控制损害。
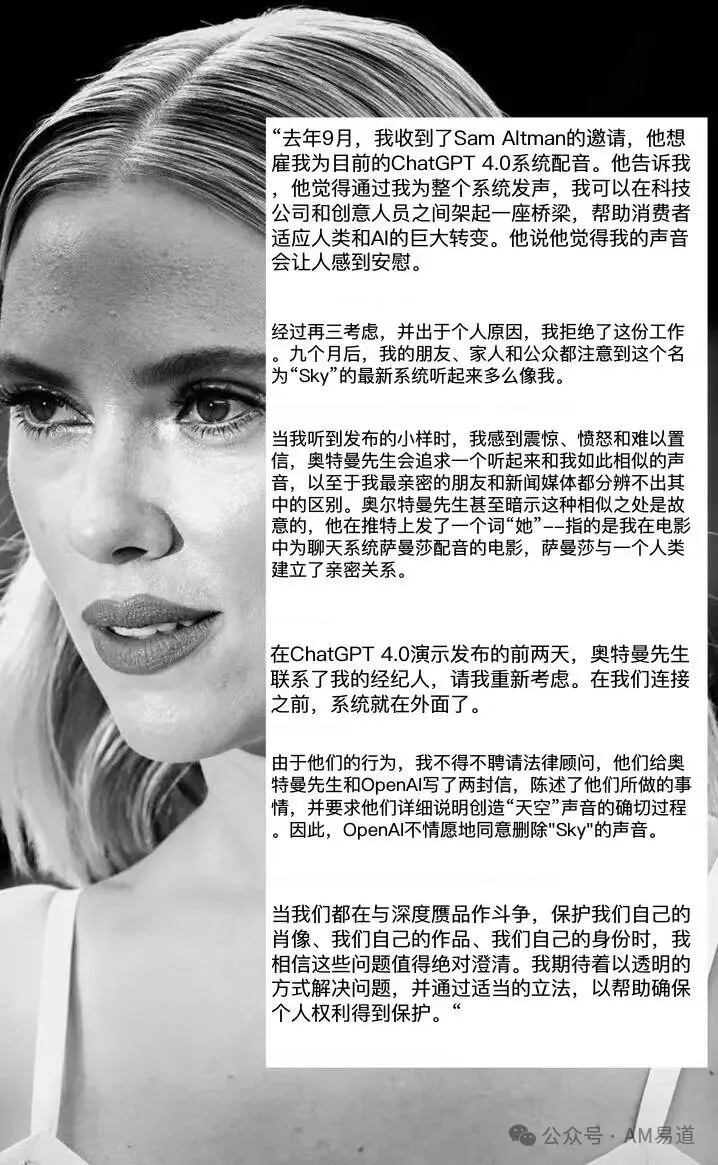 配图为AM易道从其他网络来源配图
除此之外,OpenAI在GPT-4o上还犯了另一个错误:
用于训练其「分词器」(一种帮助模型更高效地解析和处理文本的工具)的数据被中文垃圾网站所污染。
结果,该模型的中文标记库充斥着与色情和赌博相关的短语。
这可能会加剧AI模型常见的问题:出现幻觉、糟糕的性能以及被误用。
在几位研究人员和AI行业内部人士指出这个问题后,我于上周五撰文分析了这一情况。
他们查看了GPT-4o公开的标记库(该库在新模型中得到显著更新,以改进对非英语语言的支持),发现在模型用于训练的100个最长中文标记中,有90多个来自垃圾网站。这些短语包括「免费观看日本XX视频」、「赛车投注」和「中国福利彩票每天」等。
任何会读中文的人都能立即发现这个标记列表的问题。
由于成人内容在网上太过普遍,一些此类短语不可避免地会混入训练数据集。
但占到用于训练模型的中文语言的90%?这着实令人震惊。
「作为一个中国人,看到这些让人尴尬。中文数据的质量就是这样的吗?是因为数据清洗不够,还是语言本身就是这样?」 卡内基梅隆大学计算机科学博士生Geng Zhengyang说道。
从OpenAI为GPT-4o选择的标记语句中,人们可能很容易对某种语言或文化下定论。
毕竟,这些标记被视为相应语言中常见且重要的短语。
香港研究员罗亨利撰写了一篇有趣的博客文章,他查询了GPT-4o在不同语言中最长的标记,发现它们似乎有不同的主题。
俄语标记反映了关于政府和公共机构的语言,而日语标记则有许多表达「谢谢」的不同方式。
但我认为,这更能说明网上容易获得什么样的训练数据,以及OpenAI为GPT-4o抓取了哪些网站,而不是反映不同文化或国家之间的差异。
在我发表这篇文章后,加州大学圣地亚哥分校政治学教授在社交媒体X(前推特)上评论道:「当你试图不使用中国官媒内容进行训练时,就会得到这样的结果。」
这半是玩笑,半是在指出训练大型语言模型说中文面临的两大问题:网上容易获得的数据要么反映了官方认可的谈论中国的方式,要么就是无处不在的垃圾内容淹没了真实对话。
事实上,在GPT-4o为数不多的非色情赌博废话的长中文标记中,有两个是「中国特色社会主义」和「中华人民共和国」。
这些短语的出现表明,相当一部分训练数据实际上来自官媒的文章,其中正式的长表达极为常见。
OpenAI历来对其用于训练模型的数据守口如瓶,它可能永远不会告诉我们其中文训练数据库中有多少是官方媒体,多少是垃圾信息。(OpenAI没有回应MIT Technology Review发出的详细问题。)
但它并非唯一面临这一问题的公司。
在中国从事人工智能行业的人士也认为,缺乏高质量的中文文本数据集来训练大型语言模型。
原因之一是中国互联网过去一直由腾讯、字节跳动等大公司瓜分,而且很大程度上仍是如此。
它们拥有大部分社交平台,不会与竞争对手或第三方分享数据来训练大型语言模型。
事实上,这也是为什么包括谷歌在内的搜索引擎在搜索中文内容时效果不佳。
由于微信内容只能在微信上搜索,抖音(中国版TikTok)内容只能在抖音上搜索,这些数据无法被第三方搜索引擎访问,更不用说大型语言模型了。
但这些平台才是真实人类对话发生的地方,而不是那些一直试图引诱你进行在线赌博的垃圾网站。
缺乏高质量的训练数据比未能过滤GPT-4o标记训练数据中的色情和一般废话的失败更为严重。
如果没有现成的数据集,人工智能公司就必须投入大量工作来识别、采集和整理自己的数据集,并过滤掉不当或有偏见的内容。
OpenAI似乎没有做到这一点,这在一定程度上是可以理解的,因为中国区是禁用OpenAI人工智能模型的。
尽管如此,仍有许多生活在中国以外的人希望使用中文人工智能服务。他们和其他任何语言的使用者一样,都应该获得正常工作的产品。
AM易道结语:
GPT-4o在中文数据训练方面的失误,无疑给国内人工智能企业带来了弯道超车的机遇。
相较于OpenAI这样的国外巨头,本土企业更加熟悉中文语境,更容易获取高质量的中文数据资源。
然而,正如文中所提到的,当前国内互联网生态呈现割裂状态,腾讯、字节跳动等大厂各自为政,优质数据被圈在看不见的「围墙」内。这不仅阻碍了通用人工智能模型的发展,也限制了整个行业的创新潜力。
要打破这一僵局,恐怕还需要国家层面的政策引导和顶层设计。
主管部门应积极推动行业标准的制定,在保护用户隐私和企业商业机密的前提下,探索跨平台数据共享的机制。
我国大模型发展尚在追赶美国,若各大企业文本数据资源能充分流动共享,我国的人工智能事业将在全球竞争中赢得主动。
各位读者,如果在各类大模型的回复里看到了「垃圾信息」,你该如何应对?
 点赞
 反对
 收藏
 分享

AM易道
读懂3D打印卓越与演变之道
 标签
 近期热门


 读懂3D打印卓越与演变之道
 京公网安备11010802046387号
 AM易道
 粒子熔炉