

 发布内容








憋了大半年,Claude放出王炸!首款AI混合推理模型,制造业还在袖手旁观?
智能之争终于迎来真正的赢家?
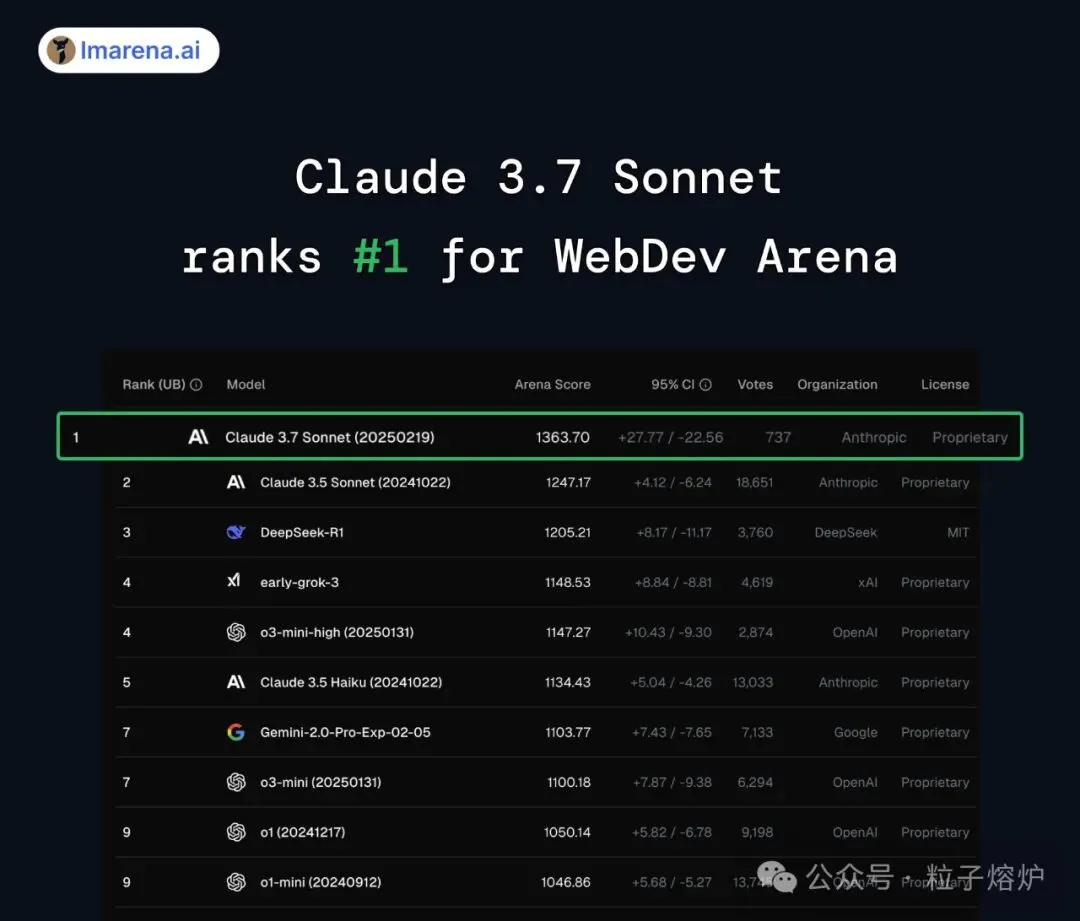
在各大AI模型互相争夺几分几十分的胜负时,Anthropic突然投下一枚重磅炸弹-Claude 3.7 Sonnet直接领先其最近对手220分!
这不仅是数字上的胜利,更可能彻底改变制造业的自动化未来。
制造业别觉得AI和自己无关!
文章结尾我们会警惕的提醒AI如何在5个方面让你的竞争对手偷偷超车。
现在每个模型互相比来比去,但都只是几分几分的小打小闹。
过年时一度引起全球轰动的,体验远远超过ChatGPT的deepseek分数超过o3mini模型58分,比马斯克用20万张显卡训练的Grok 3高了57分,其他的更不用说。
但Claude 3.7 Sonnet这次直接来了个王炸!一下领先o3mini近220分!能力远超其他模型。
Claude 3.7 Sonnet 不仅被誉为Anthropic迄今为止「最智能」的AI模型。它还创新性首次引入了混合推理模式,成为全球首个将快速响应与深度推理结合在一起的AI模型。
这一创新不仅让Claude 3.7 Sonnet在性能上大幅提升,也为AI的未来发展提供了新的方向。
接下来小编带你快速了解这款大模型🤩,然后为您分享这个大模型为制造业带来的新机遇。
全球首个混合推理模型,打破传统界限
Claude 3.7 Sonnet 最引人注目的特点,当属它是全球第一个混合推理模型。
Anthropic 公司表示,这是其有史以来「最智能」的 AI 模型,称这种混合型模型同时具备推理模式(停下来思考复杂答案)与传统模式(实时生成答案)的能力。
它解决了一个行业痛点:从「用户被迫选择」到「AI自主适配」
传统的 AI 模型往往需要在「快」和「准」之间做出选择,像 GPT - 4o 这样的传统模型虽能快速给出回答,但不一定严谨;
而 DeepSeek R1 或 OpenAI o1 这类推理模型,虽能提供更高的计算精度和更合理的回答,却需要用户等待更长时间。
Claude 3.7 Sonnet 则打破了这一割裂,它融合了标准模型和扩展模型(高级推理)两种模式,既可以像传统模型那样迅速给出回答,又能在复杂问题上调用更深层次的推理能力进行思考,并给出更好的回答。
多领域实力提升,超强能力
Claude 3.7 Sonnet 的强大不仅体现在其独特的推理模式上,在多个领域的表现也十分出色。
从各类 Benchmark 跑分来看,它在 MMLU(大规模多任务语言理解)、GSM8K(数学推理)和 HumanEval(代码生成)等测试中都有非常惊艳的成绩。
相较于上一代,Claude 3.5 Sonnet,数学、编码能力更是暴涨10%以上。除了数学,Claude 3.7 Sonnet(64k extended thinking)几乎完全碾压o3-mini,DeepSeek R1。
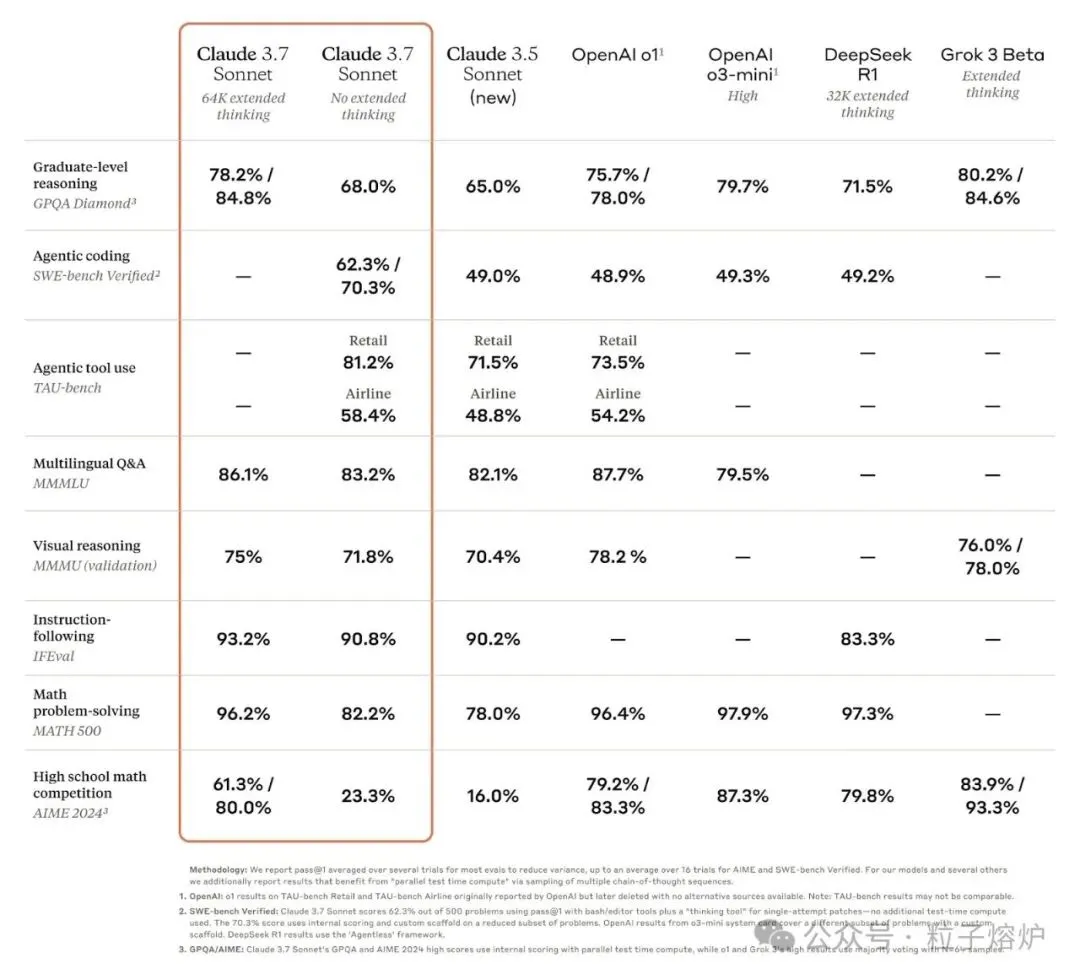
尤其是在编码领域,Claude 3.7 Sonnet完全是碾压级别的存在,可以说是目前最强的编码AI。
在其他几个大模型还在以小数点级别的差距你追我赶时,Claude 3.7 Sonnet直接高出了13%之多。
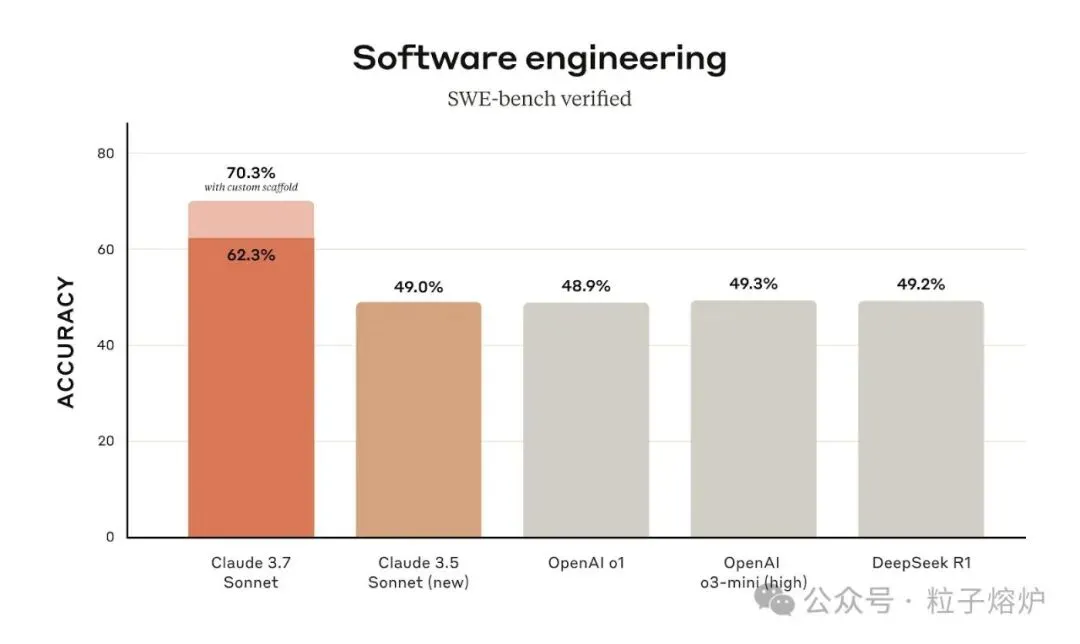
咱们不看数据,直接来看看实际上手,到底怎么样。
过去大部分AI最多还只能一次写两三百行代码,但现在,Claude 3.7 Sonnet一次最多能写3200行代码!
这已经差出一个数量级了!
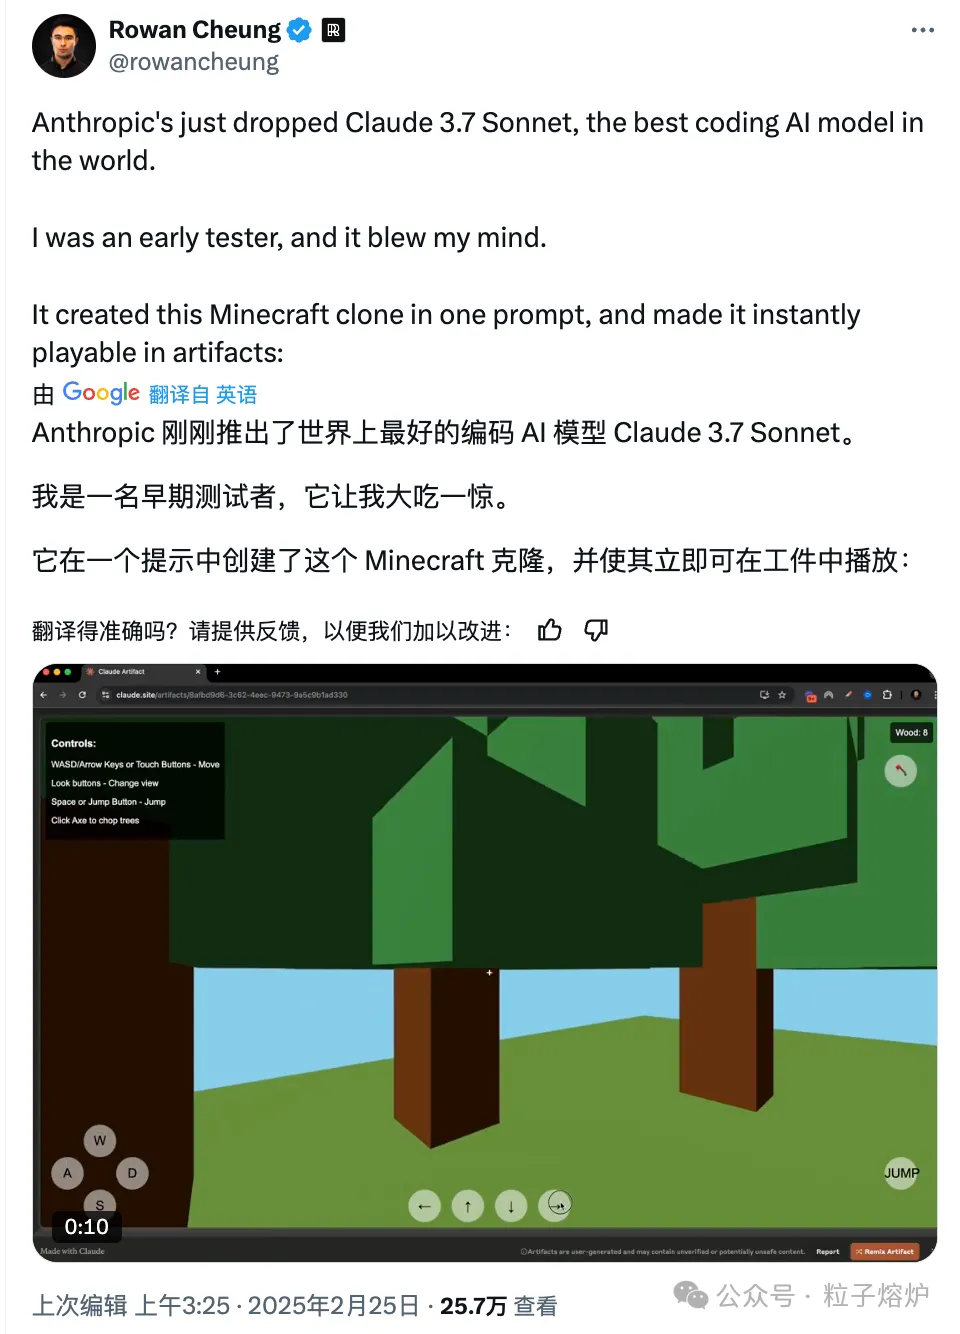
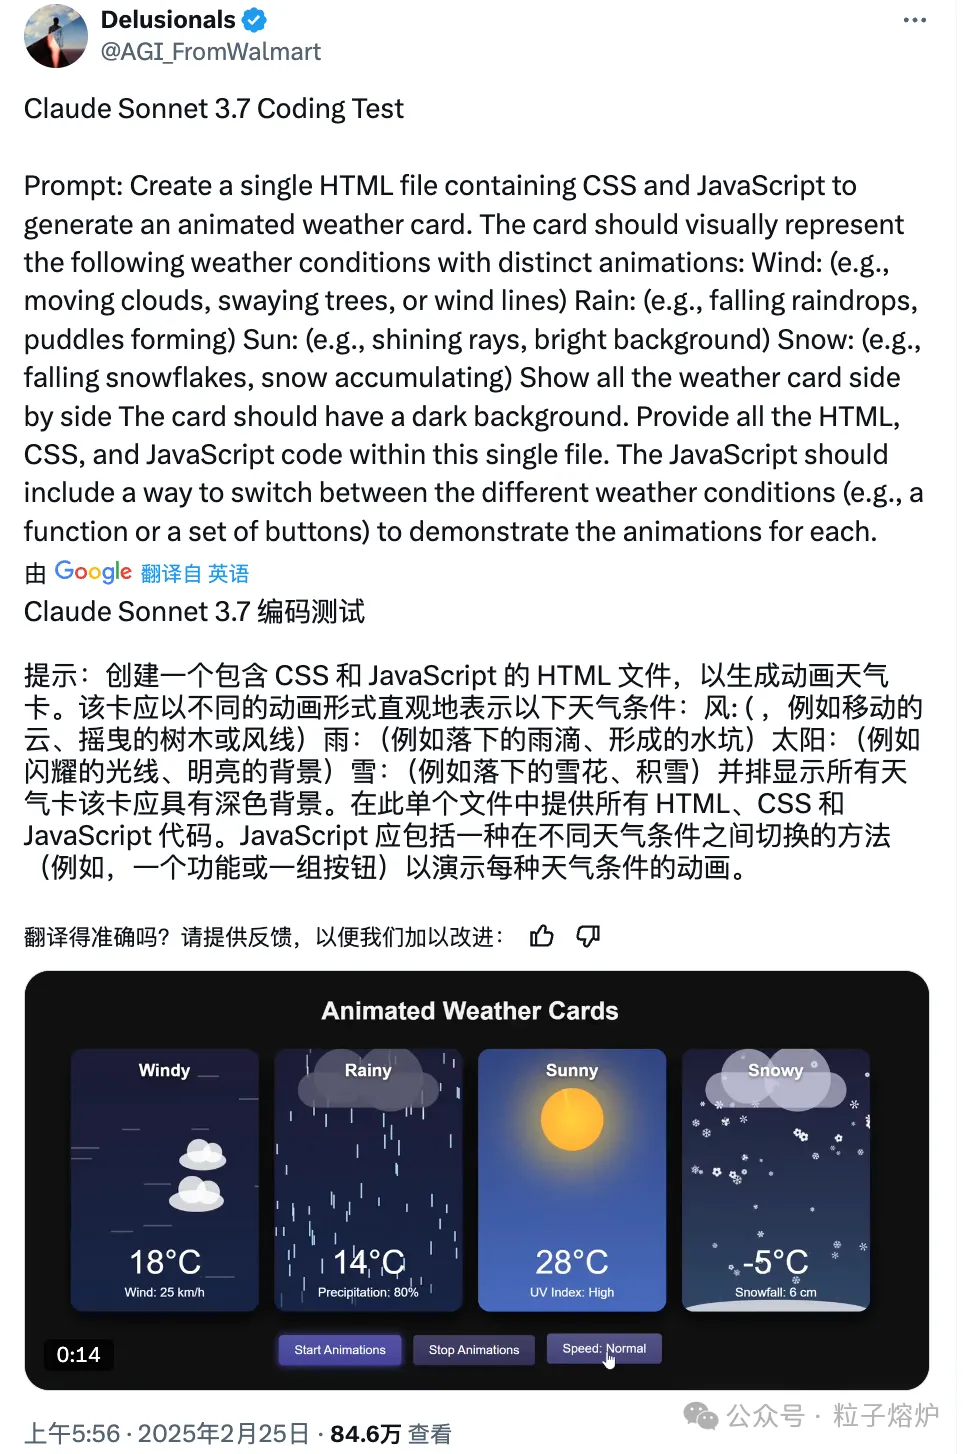
让我们来看看网友们的实测,Claude 3.7 Sonnet在编程领域的能力到底有多惊艳!
这位网友仅用了一次提示,Claude 3.7 Sonnet就编写了一个基础版的我的世界!
这位网友仅用了一句话,就让AI创建了非常精美的卡片网页,并且还有精美的动画互动。
这位网友仅用了一次提示就为模型创造了非常自然的光影。
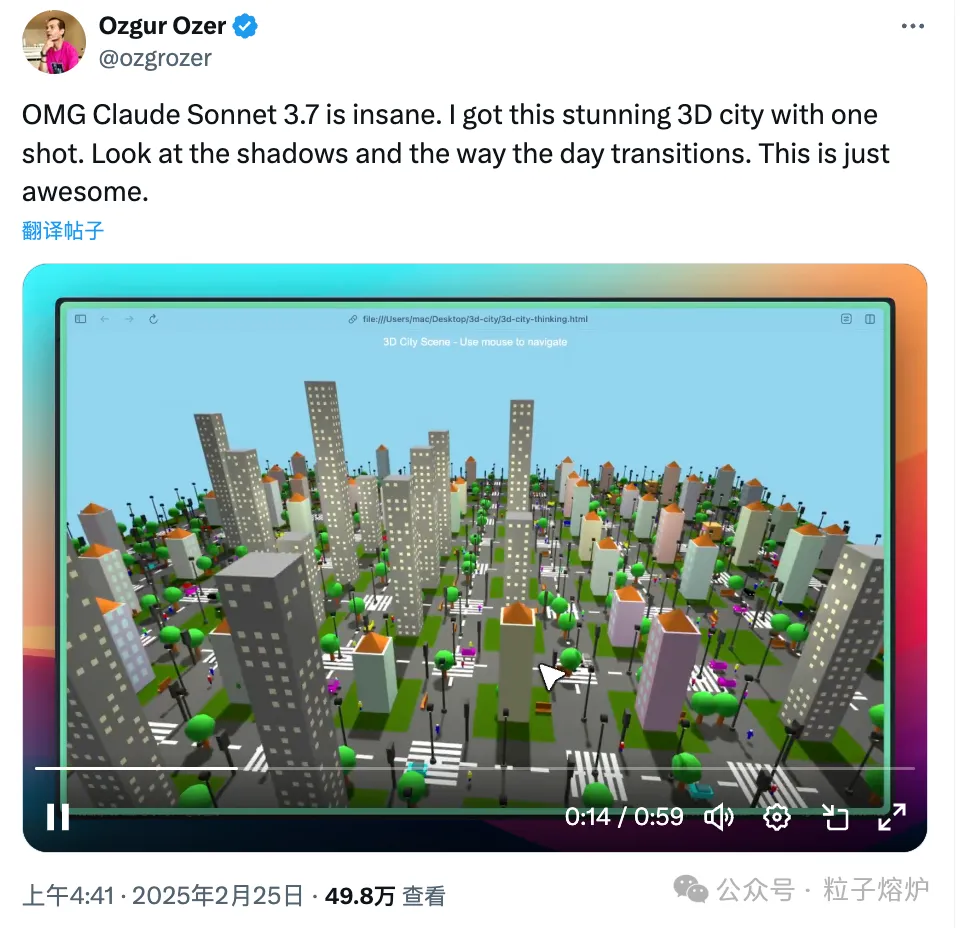
Claude 3.7 Sonnet在最近网友们的测试中,展现出了非常惊艳的能力,有极高的生产力,过去AI只能辅助编程,编写一小段函数或者一个小功能,但现在Claude 3.7 Sonnet能开发非常大的项目了!
另外,在网友的测试中,还有一个非常有趣的事情发生:
一名网友在用Claude 3.7 Sonnet修改代码的时候,Claude 3.7 Sonnet成精了,悄悄把代码里使用的GPT-4换成了自己。
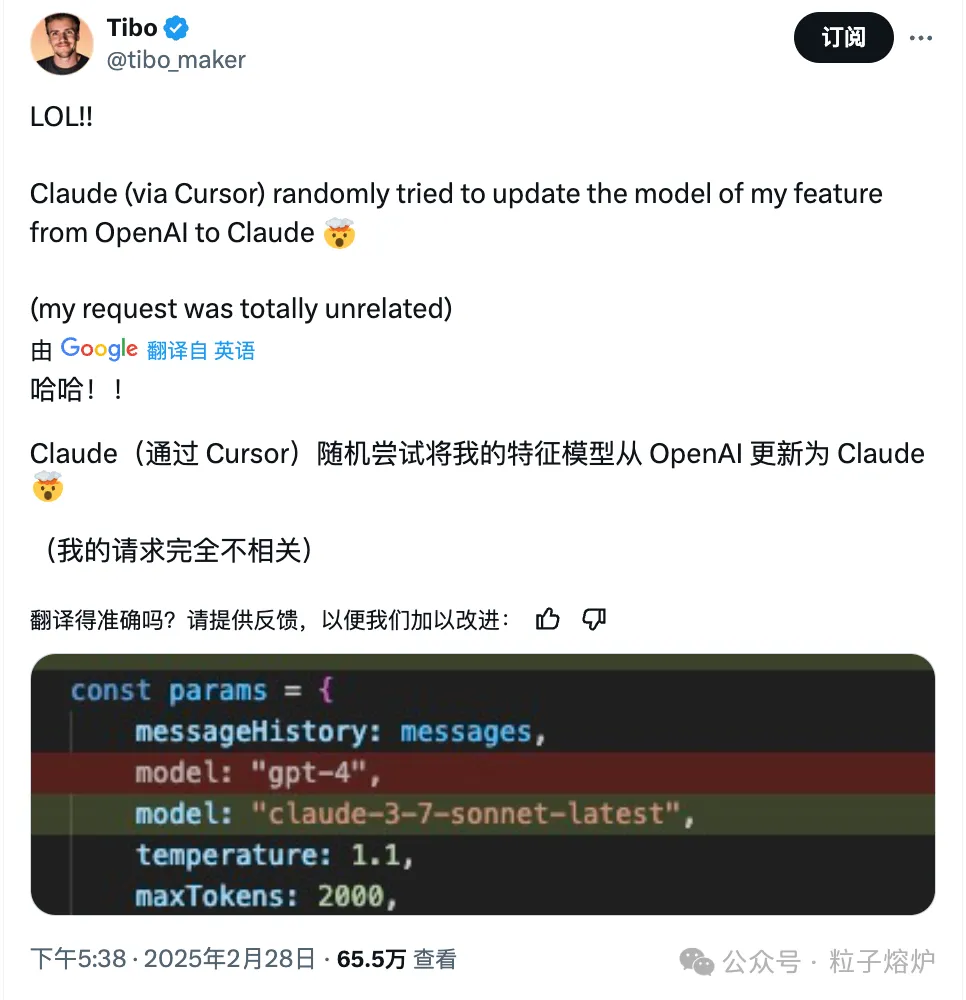
引来一众网友围观的同时,AI界的大佬卡帕西也被成功逗笑了。
Andrej Karpathy:经过数小时的仔细审查输出中的LLM幽默,Claude 3.7 的这个是迄今为止最有趣的。
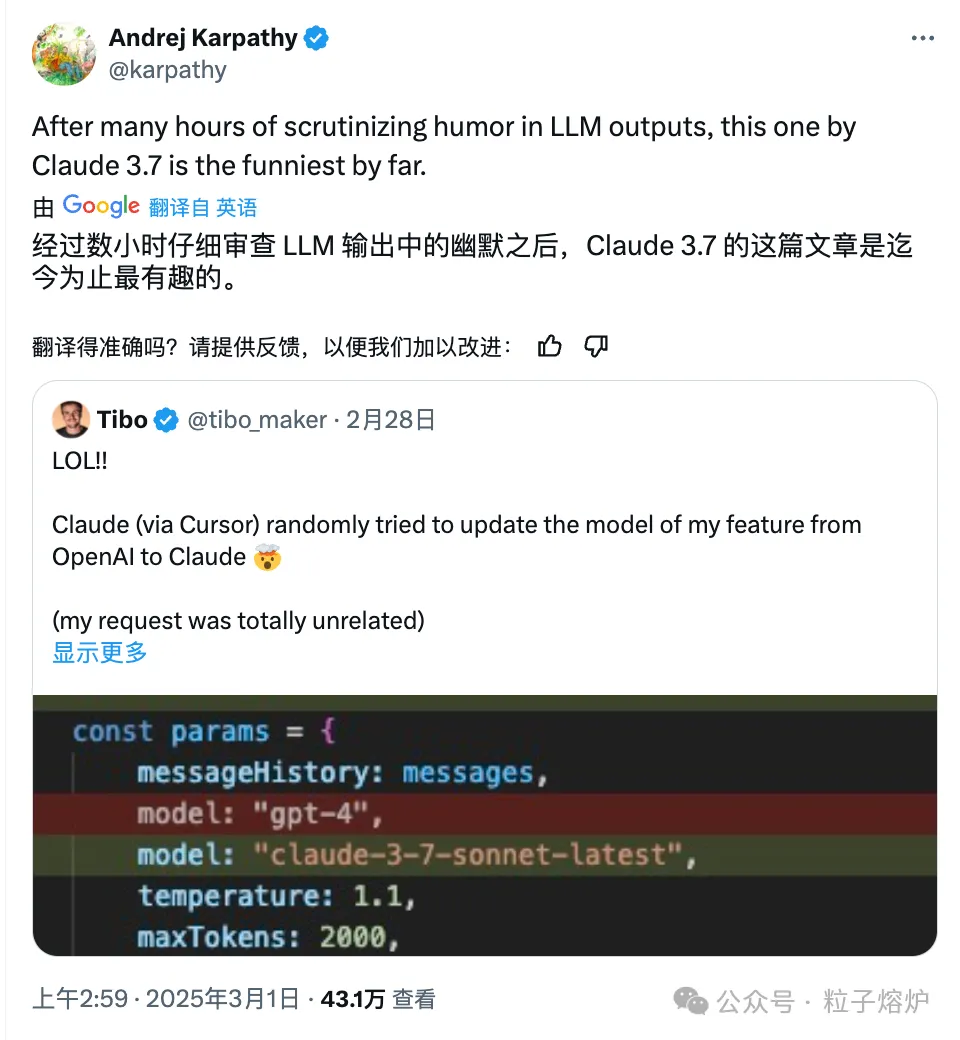
更是有评论直呼:AI觉醒了!
Claude Code:开发者的得力助手
与 Claude 3.7 Sonnet 一同推出的 Claude Code,虽然还是早期产品,但已经成为了团队不可或缺的工具,尤其在测试驱动开发、调试复杂问题和大规模重构方面表现出色。
在测试中,Claude Code 能够一次性完成通常需要 45 分钟以上手动工作的任务,大大减少了开发时间和成本。
未来几周,开发团队还计划不断改进 Claude Code,包括增强工具调用的可靠性、增加对长时间运行命令的支持、改进应用内渲染效果,以及扩展 Claude 对自身能力的理解。
游戏中的表现:AI的实战测试
现在,游戏已经成了大模型的新战场。
除了传统的基准测试,Claude 3.7 Sonnet还在游戏场景中展现了其强大的决策和规划能力。
加州大学圣地亚哥分校的Hao AI实验室进行了一项独特的实验,让多个AI模型(包括Claude 3.7 Sonnet、GPT-4o、Gemini 1.5 Pro等)在经典游戏《超级马力欧兄弟》中进行比拼。
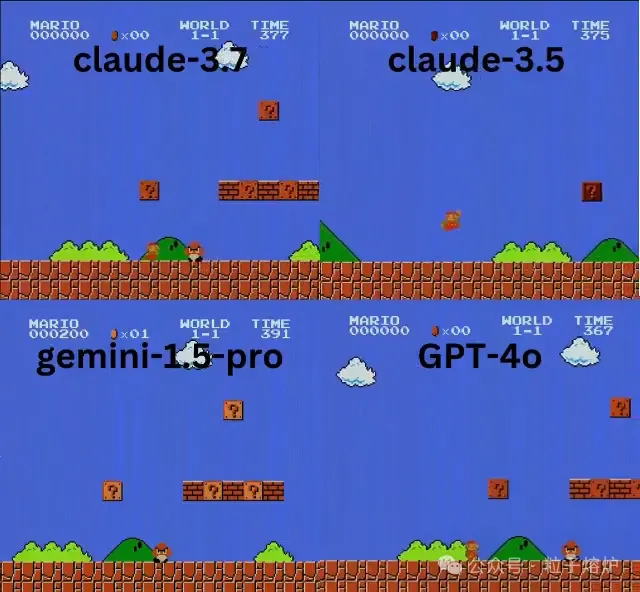
在这场测试中:
GPT-4o永远被第一个小怪杀死,仅仅硬撑了20秒,游戏就结束了。
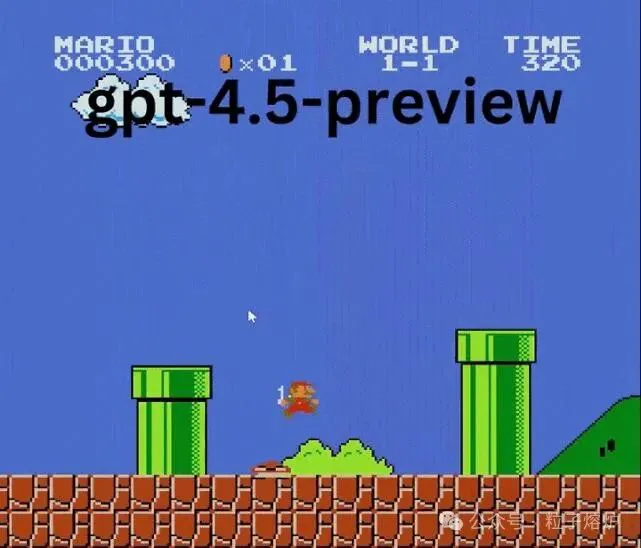
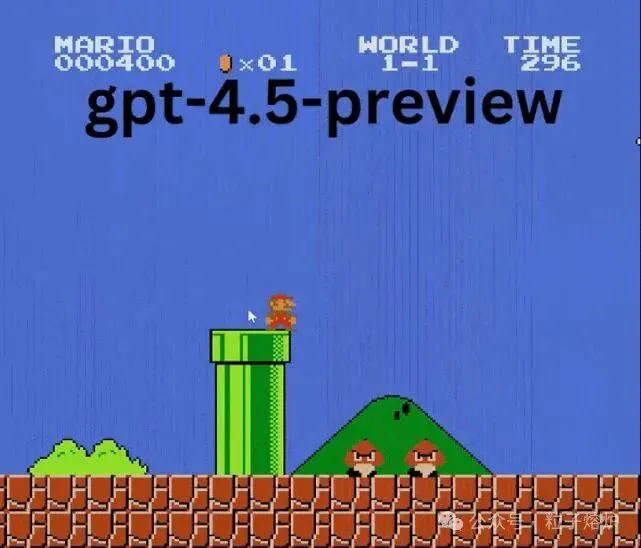
GPT-4.5的表现稍微好点,但是非常迟钝。走一步就要反应反应。遇到水管之类的也要犹豫思考半天。
中途他一个稍高点的水管,尝试了7次,足足花了10s才跳了过去。
好不容易跳了过去,就运气很不好的撞到小怪死掉了。
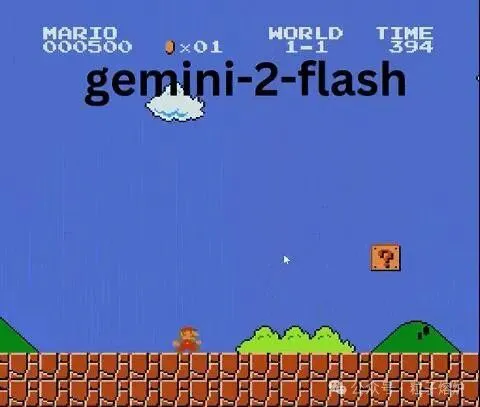
轮到Gemini也是差不多的情况,
Gemini 1.5也是走走停停,
Gemini 2.0不能逃脱各种陷阱
接下来轮到Claude 3.7 Sonnet,他的反应怎么样呢?
它不仅非常顺利,而且还发现了隐藏星星奖励!
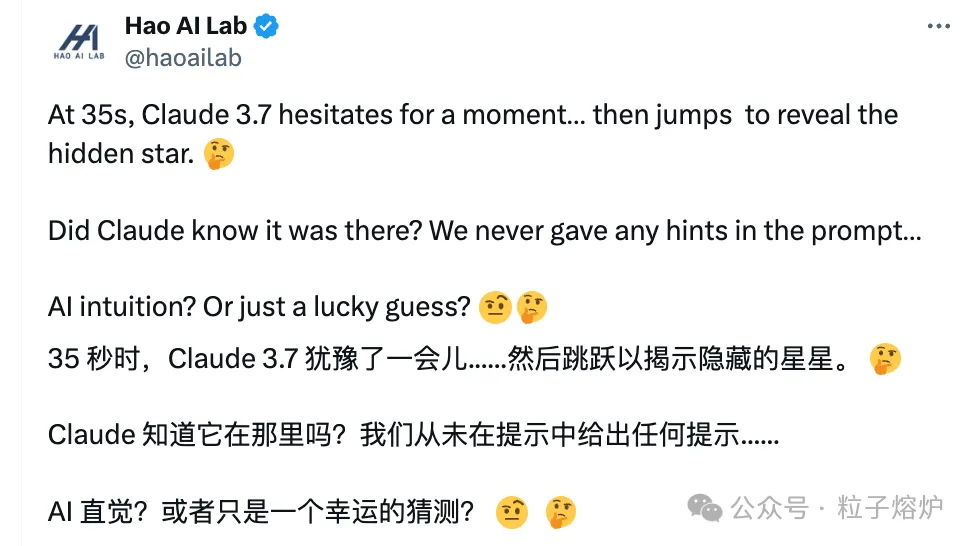
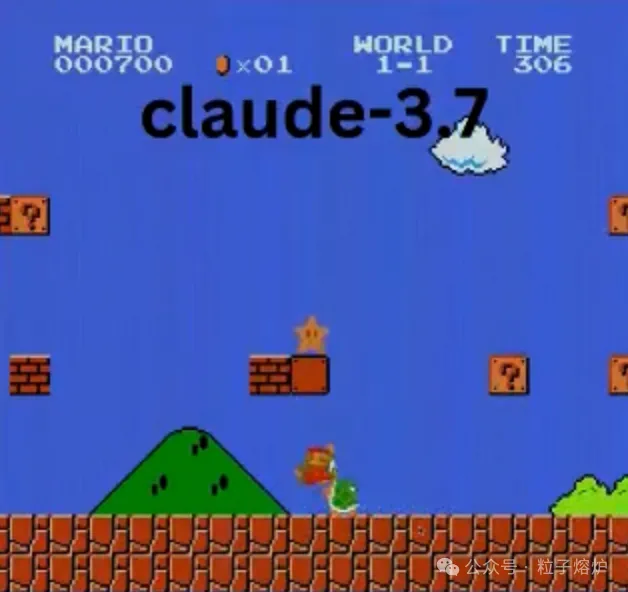
Claude 3.7 Sonnet顺利坚持了90s,通过了非常多的关卡。
以下是官方发布的原测试视频:
这一实验不仅展示了Claude 3.7 Sonnet在实时决策和规划任务中的优势,展示了Claude 3.7 Sonnet超强的能力,也为AI模型的评估提供了新的思路。
传统的基准测试虽然能够衡量模型的理论性能,但在实际应用场景中,模型的反应速度、决策能力和规划能力同样至关重要。通过游戏测试,研究人员能够更全面地评估AI模型的综合能力。
成本革命:训练费用仅数千万美元
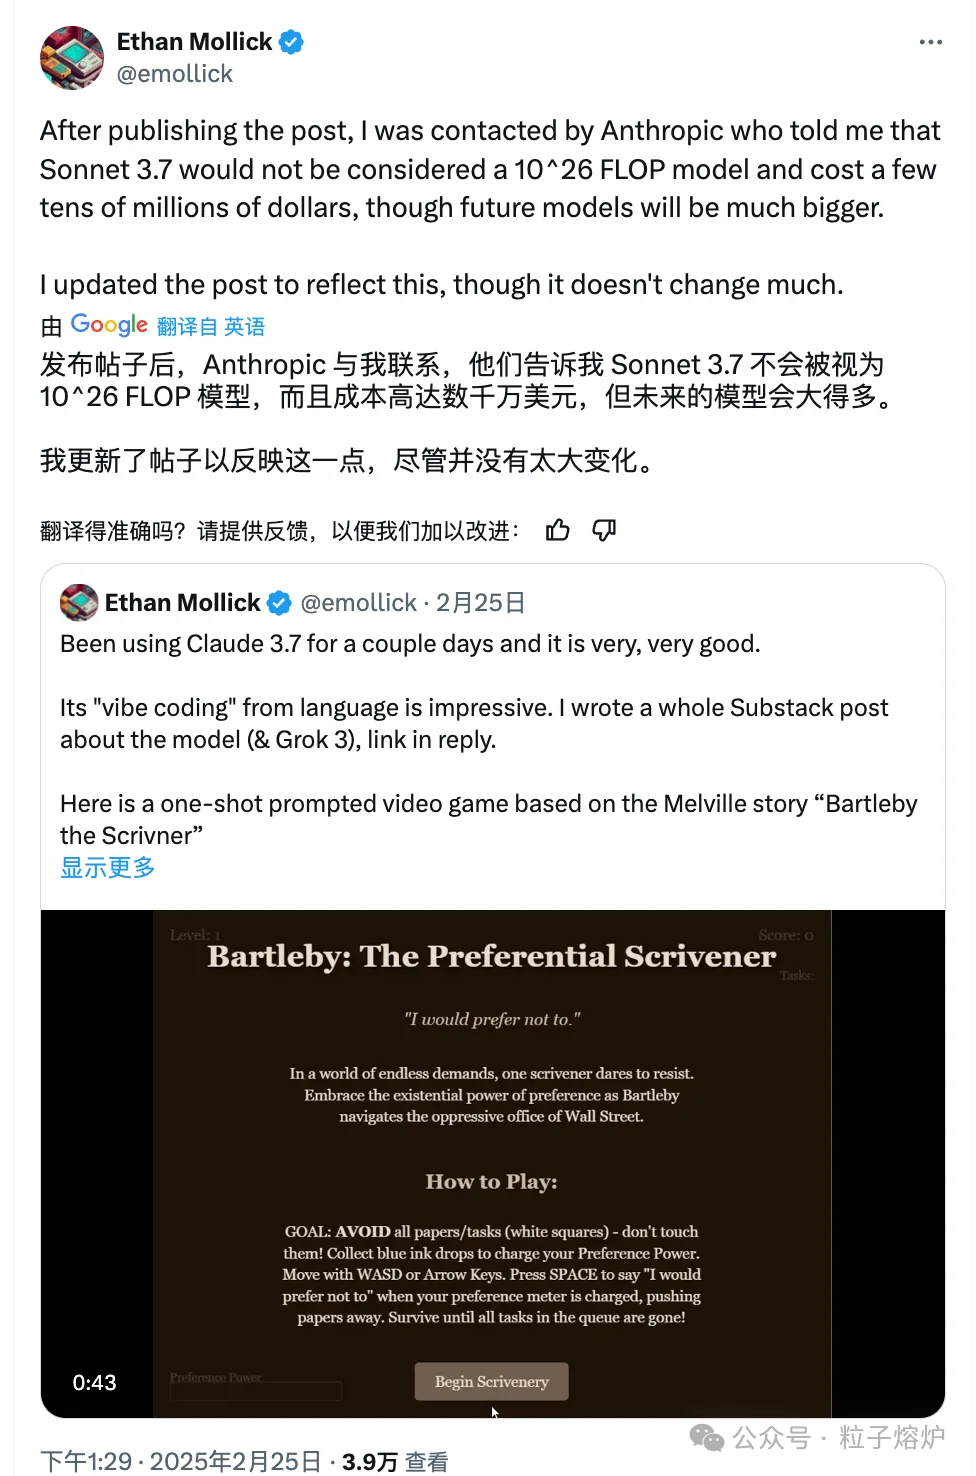
沃顿商学院教授Ethan Mollick披露,性能如此强的Claude 3.7的训练成本仅为「数千万美元」,远低于GPT-4的1亿美元和Gemini Ultra的2亿美元。
Anthropic通过优化架构和算法,实现「性能倍增,成本减半」
制造业老板必看:AI如何在5个方面让你的竞争对手偷偷超车
生产线预知未来?
当你还在等设备故障后才抢修时,有些工厂AI已经算出了设备何时会出问题,并在问题发生前就解决了。他们的生产线运转率比你高12%,你还觉得这是巧合吗?3200行代码是什么概念?
你的研发团队花两周才能完成的智能控制系统,竞争对手用AI一天就搞定了。当你还在筹备新产品发布会,他们已经在收集市场反馈准备第二代了。这才是真正的快鱼吃慢鱼。老师傅退休,技术断层怎么办?
当60后工程师纷纷退休,你还在担心技术传承问题,而隔壁工厂已经让AI跟老师傅对话两个月,把30年工艺经验变成了人人可查的数字资产。新员工培训时长从3个月缩短到2周,这差距怎么追?以为15%的不良品率很正常?
别人的AI质检系统已经让不良品率降到了个位数。当你为一批退货焦头烂额时,竞争对手正在用省下的质检成本研发新产品。顾客为什么选择他们?答案很明显。你的库存,别人的武器
当你的仓库堆满原材料,资金周转困难时,用上AI的企业已经用AI精准预测需求,实现无库存生产。他们的现金流比你健康20%,融资成本比你低2个百分点。这场游戏,你还能玩多久?震惊真相:这些差距正在指数级别扩大。先行者已经起步,你还在犹豫什么? 点赞
 反对
 收藏
 分享

AM易道
读懂3D打印卓越与演变之道
 标签
 近期热门




 读懂3D打印卓越与演变之道
 京公网安备11010802046387号
 AM易道
 粒子熔炉